Análisis de Datos
Limpieza de Datos con Python y Pandas: Guía Práctica para Analistas
Por Gastón Martos · 26 de octubre de 2026 · 3 min de lectura
Limpieza de datos con Python y Pandas: Guía práctica para analistas
En los proyectos reales de Business Intelligence y analítica, rara vez te vas a encontrar con tablas ordenadas y listas para graficar. Se estima que entre el 60% y el 80% del tiempo de un proyecto se destina a la limpieza y transformación de datos (Data Wrangling).
Aunque herramientas como Power Query o consultas estructuradas en bases relacionales resuelven gran parte de esta tarea, Python junto con la librería Pandas es el estándar absoluto cuando se requiere automatización, manipulación avanzada de texto o procesamiento de múltiples archivos simultáneos. Si estás dando tus primeros pasos en esta disciplina, te recomendamos revisar nuestra guía sobre cómo empezar en análisis de datos. A continuación, repasamos el flujo paso a paso para depurar un dataset desde cero.
1. Carga del archivo y diagnóstico inicial
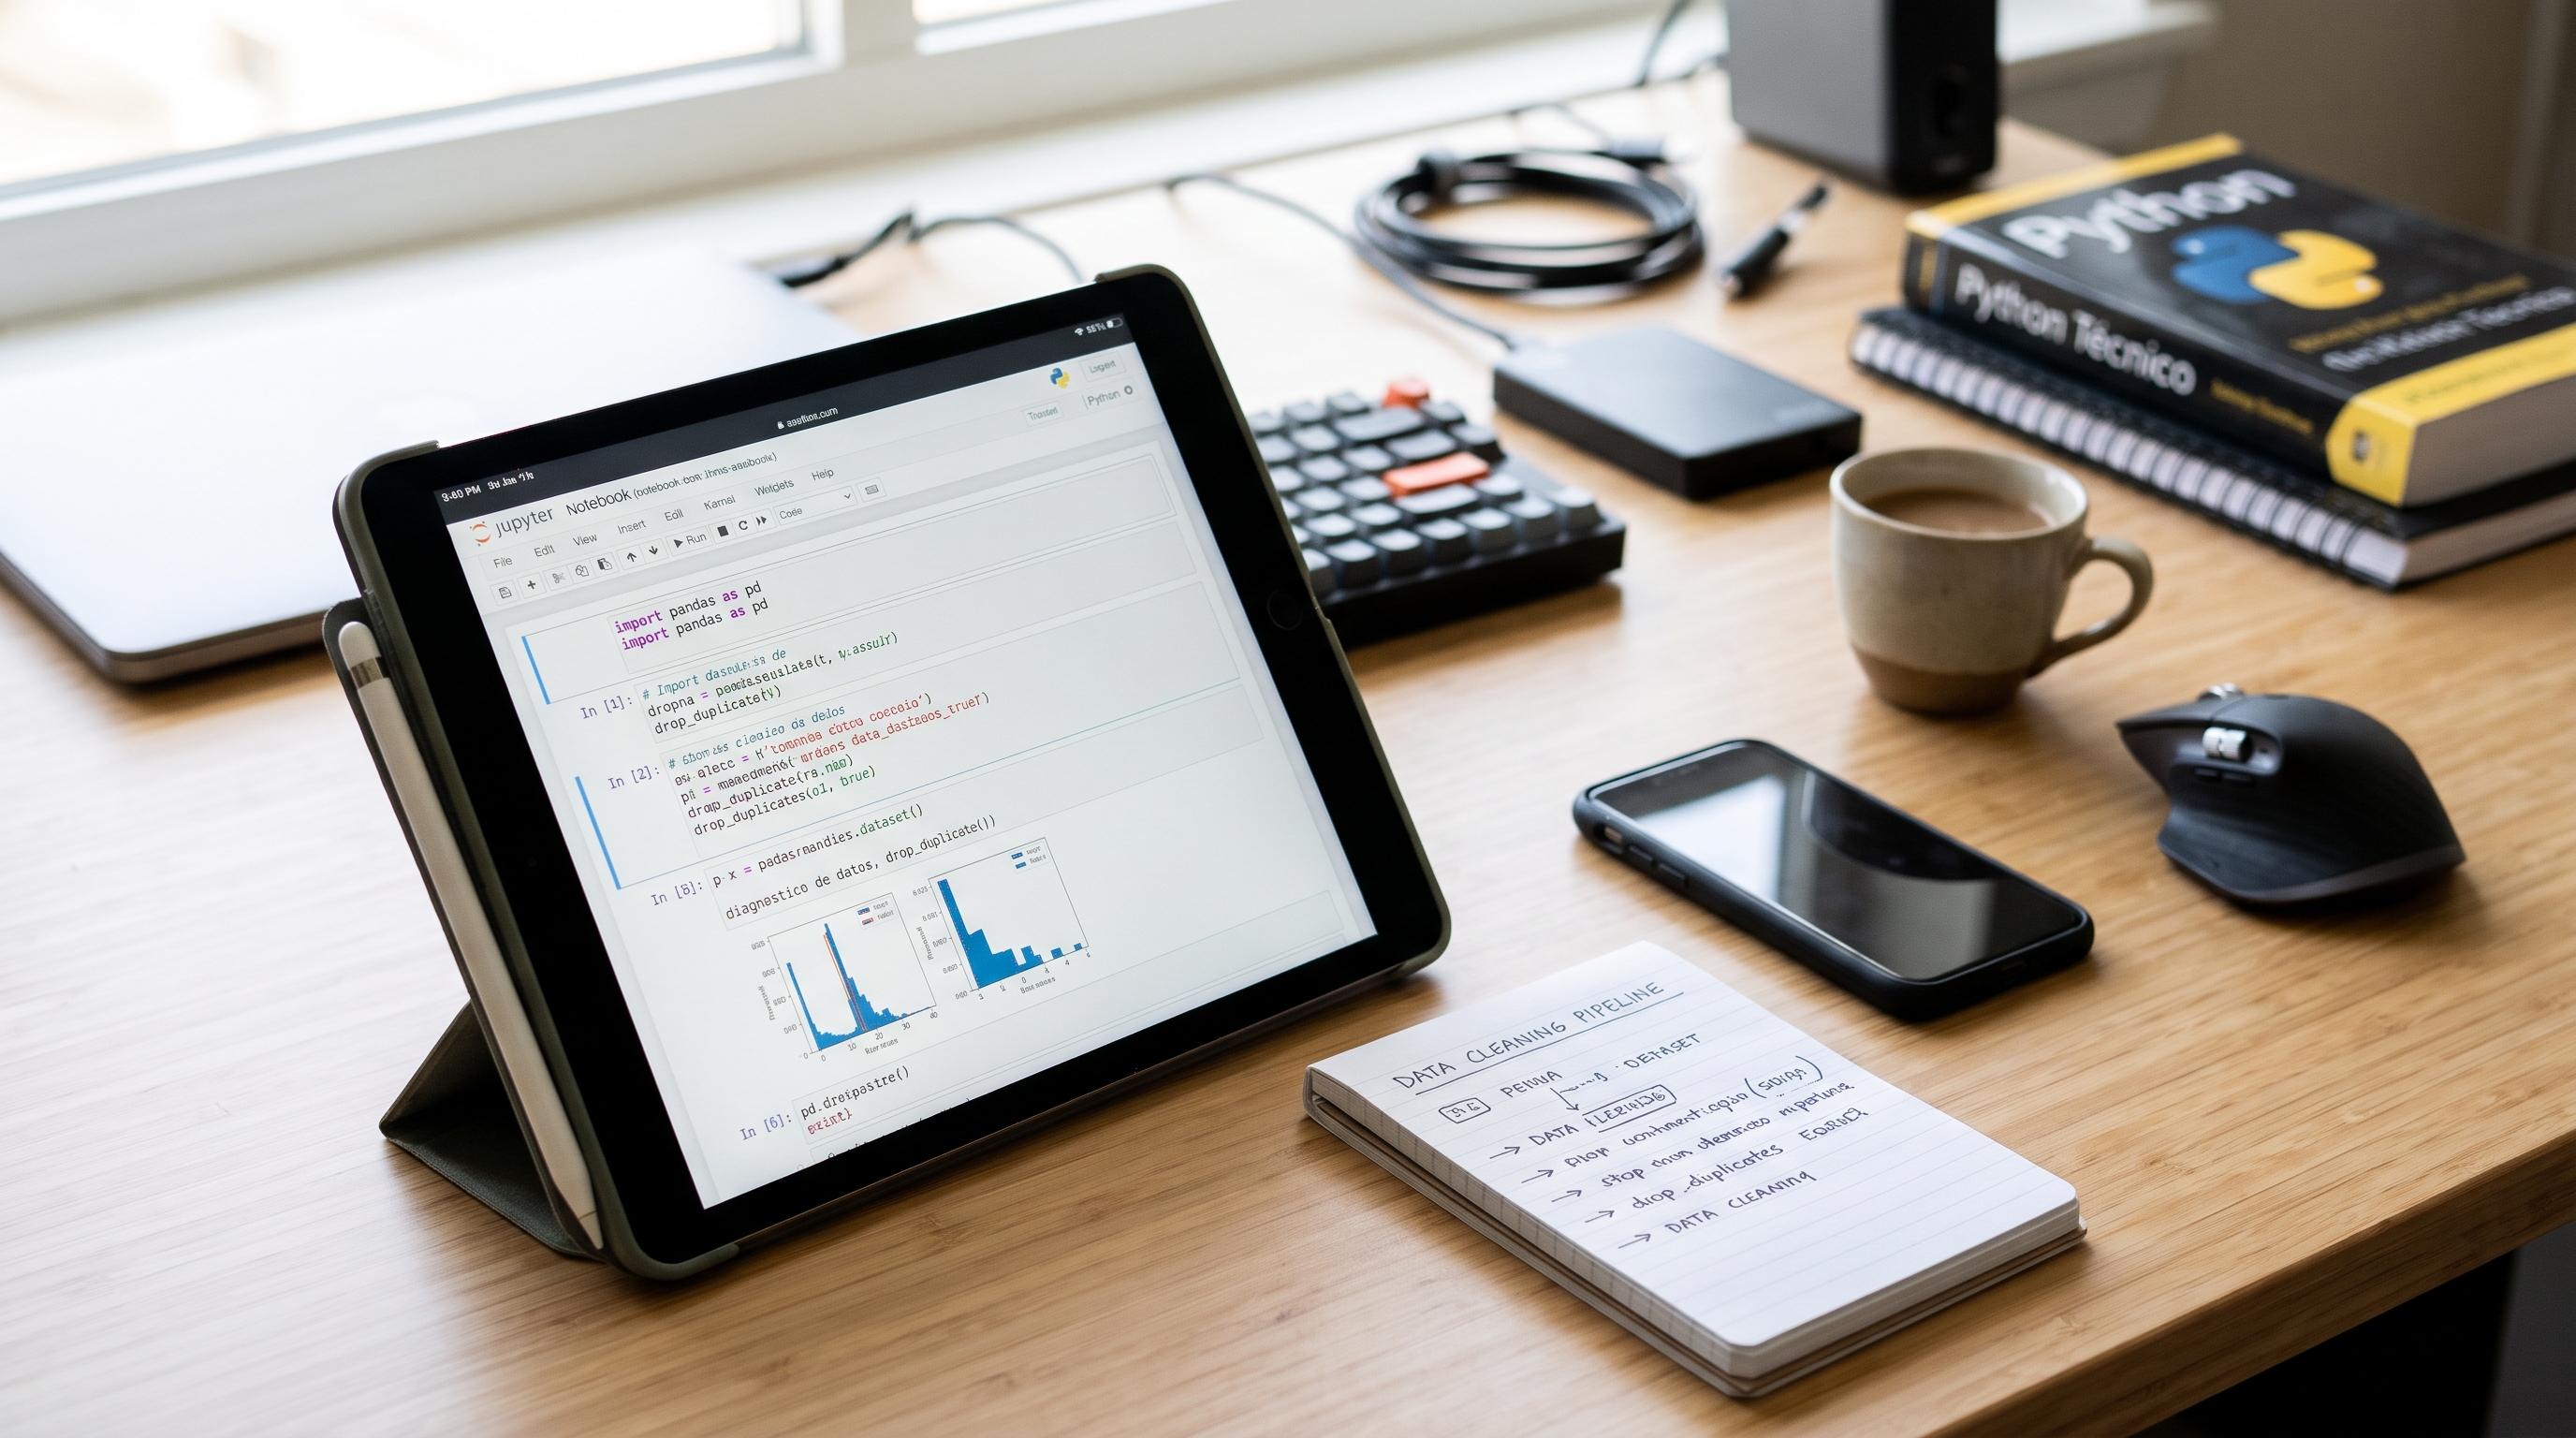
Antes de modificar cualquier dato, es indispensable auditar la calidad del archivo para detectar inconsistencias estructurales, columnas con tipos erróneos o valores ausentes.
import pandas as pd

# Cargar el dataset desde un archivo CSV
df = pd.read_csv('ventas_mensuales.csv')

# Inspeccionar las primeras filas y resumen técnico
print(df.head())
print(df.info())
print(df.describe())
df.info(): Permite comprobar la cantidad de filas no nulas y si las fechas o precios fueron leídos como texto (object).df.describe(): Ofrece métricas estadísticas rápidas (mínimos, máximos, medias) para descubrir valores atípicos evidentes.
2. Tratamiento de valores nulos o faltantes (NaN)
Los valores ausentes pueden distorsionar los cálculos de promedios o romper las relaciones entre tablas cuando cargás la información a un tablero.
Opciones para gestionarlos:
- Eliminar registros vacíos: Conveniente solo si el porcentaje de filas afectadas es insignificante frente al total.
# Eliminar filas donde la columna 'cliente_id' esté vacía
df_limpio = df.dropna(subset=['cliente_id'])
- Imputación de valores: Rellenar con un valor por defecto o un indicador representativo.
# Rellenar montos faltantes con la mediana o cero
df['monto'].fillna(0, inplace=True)
"No borres datos vacíos por defecto. Preguntate primero si la ausencia de información representa un error del sistema o un estado real del negocio (por ejemplo, un cliente que no registró compras este mes)."
3. Eliminación de duplicados y conversión de tipos
Los errores de carga en bases transaccionales suelen generar filas idénticas o campos numéricos interpretados como cadenas de texto.
# 1. Eliminar duplicados exactos
df.drop_duplicates(inplace=True)

# 2. Corregir tipos de datos (Strings a Datetime y Numéricos)
df['fecha_operacion'] = pd.to_datetime(df['fecha_operacion'], format='%Y-%m-%d')
df['precio_unitario'] = pd.to_numeric(df['precio_unitario'], errors='coerce')
Tener las fechas y los IDs correctamente tipados es crucial. Si más adelante vas a cruzar estos datos con servidores relacionales mediante sentencias como JOIN, cualquier discrepancia de formato impedirá la unión de tablas. Si necesitás repasar cómo interactúan estos campos en bases corporativas, leé nuestro artículo sobre SQL para analistas y sus consultas clave.
4. Estandarización de texto y variables categóricas
Los errores humanos de carga provocan que una misma categoría aparezca escrita de formas distintas (ejemplo: "buenos aires", "Buenos Aires " o "Bs As").
# Quitar espacios sobrantes y convertir a formato título
df['ciudad'] = df['ciudad'].str.strip().str.title()

# Reemplazar variantes manuales
df['ciudad'] = df['ciudad'].replace({'Bs As': 'Buenos Aires', 'Baires': 'Buenos Aires'})
Resumen del checklist de limpieza
| Problema Habitual | Método Pandas | Impacto en el Análisis |
|---|---|---|
| Valores Nulos | dropna() / fillna() |
Evita sesgos en sumatorias y métricas globales |
| Registros Duplicados | drop_duplicates() |
Previene el inflado artificial de volú |
- #limpieza de datos python
- #pandas tutorial analistas
- #data cleaning pandas
- #tratamiento valores nulos
- #python para principiantes
- #preparacion de datasets