Análisis de Datos
Cómo Modelar Datos para Dashboards: De Tablas Planas a Esquema en Estrella
Por Gastón Martos · 27 de octubre de 2026 · 4 min de lectura
Cómo modelar datos para dashboards: De tablas planas a esquema en estrella
Uno de los errores más comunes al comenzar en Business Intelligence es cargar un archivo masivo de Excel con decenas de columnas y graficar directamente sobre esa tabla plana. Aunque parece el camino más rápido, este enfoque genera dashboards lentos, cálculos redundantes y errores en los totales agregados.
El modelado dimensional es la disciplina que separa los eventos del negocio de sus atributos descriptivos para que los motores analíticos procesen millones de filas de manera eficiente. Si estás dando tus primeros pasos en esta área, podés revisar nuestra guía sobre cómo empezar en análisis de datos.
A continuación, aprenderás a estructurar un modelo de datos robusto desde cero utilizando el estándar de la industria: el esquema en estrella (Star Schema).
1. El problema de las tablas planas (Flat Tables)
Una tabla plana contiene todos los datos mezclados en una sola estructura: detalles de la orden, datos del cliente, dirección de entrega y nombres de productos repetidos en cada fila.
Desventajas técnicas de no modelar:
- Duplicación masiva de texto: El nombre o la categoría de un producto se almacena miles de veces, multiplicando el consumo de memoria.
- Ambigüedad en relaciones: Imposibilidad de comparar dos procesos comerciales distintos (por ejemplo, ventas vs presupuestos) sin duplicar métricas.
- Mantenimiento costoso: Si un cliente cambia de dirección, hay que modificar miles de filas históricas en lugar de un único registro.
Para resolver estas inconsistencias de formato y duplicidad antes de estructurar las relaciones, es fundamental aplicar técnicas de depuración previas como las detalladas en nuestra guía sobre limpieza de datos con Python y Pandas.
2. Los dos pilares: Tablas de Hechos vs Tablas de Dimensiones
El diseño dimensional organiza la información en dos categorías bien diferenciadas:
Tablas de Hechos (Fact Tables)
Contienen los eventos numéricos o transacciones ocurridas en el negocio a lo largo del tiempo.
- Ejemplos: Ventas, envíos, clics en una web, tickets de soporte.
- Contenido: Claves foráneas (IDs) y métricas cuantitativas (precio unitario, cantidad vendida, costo de envío).
- Características: Suelen tener muchas filas (millones) y pocas columnas de números.
Tablas de Dimensiones (Dimension Tables)
Contienen el contexto que responde a las preguntas ¿Quién?, ¿Dónde?, ¿Cuándo? y ¿Qué?.
- Ejemplos: Clientes, Productos, Sucursales, Calendario.
- Contenido: Clave primaria única (
ID) y atributos descriptivos (Nombre, Categoría, Ciudad, Segmento). - Características: Tienen pocas filas relativas y muchas columnas descriptivas de texto.
3. Construcción del Esquema en Estrella (Star Schema)
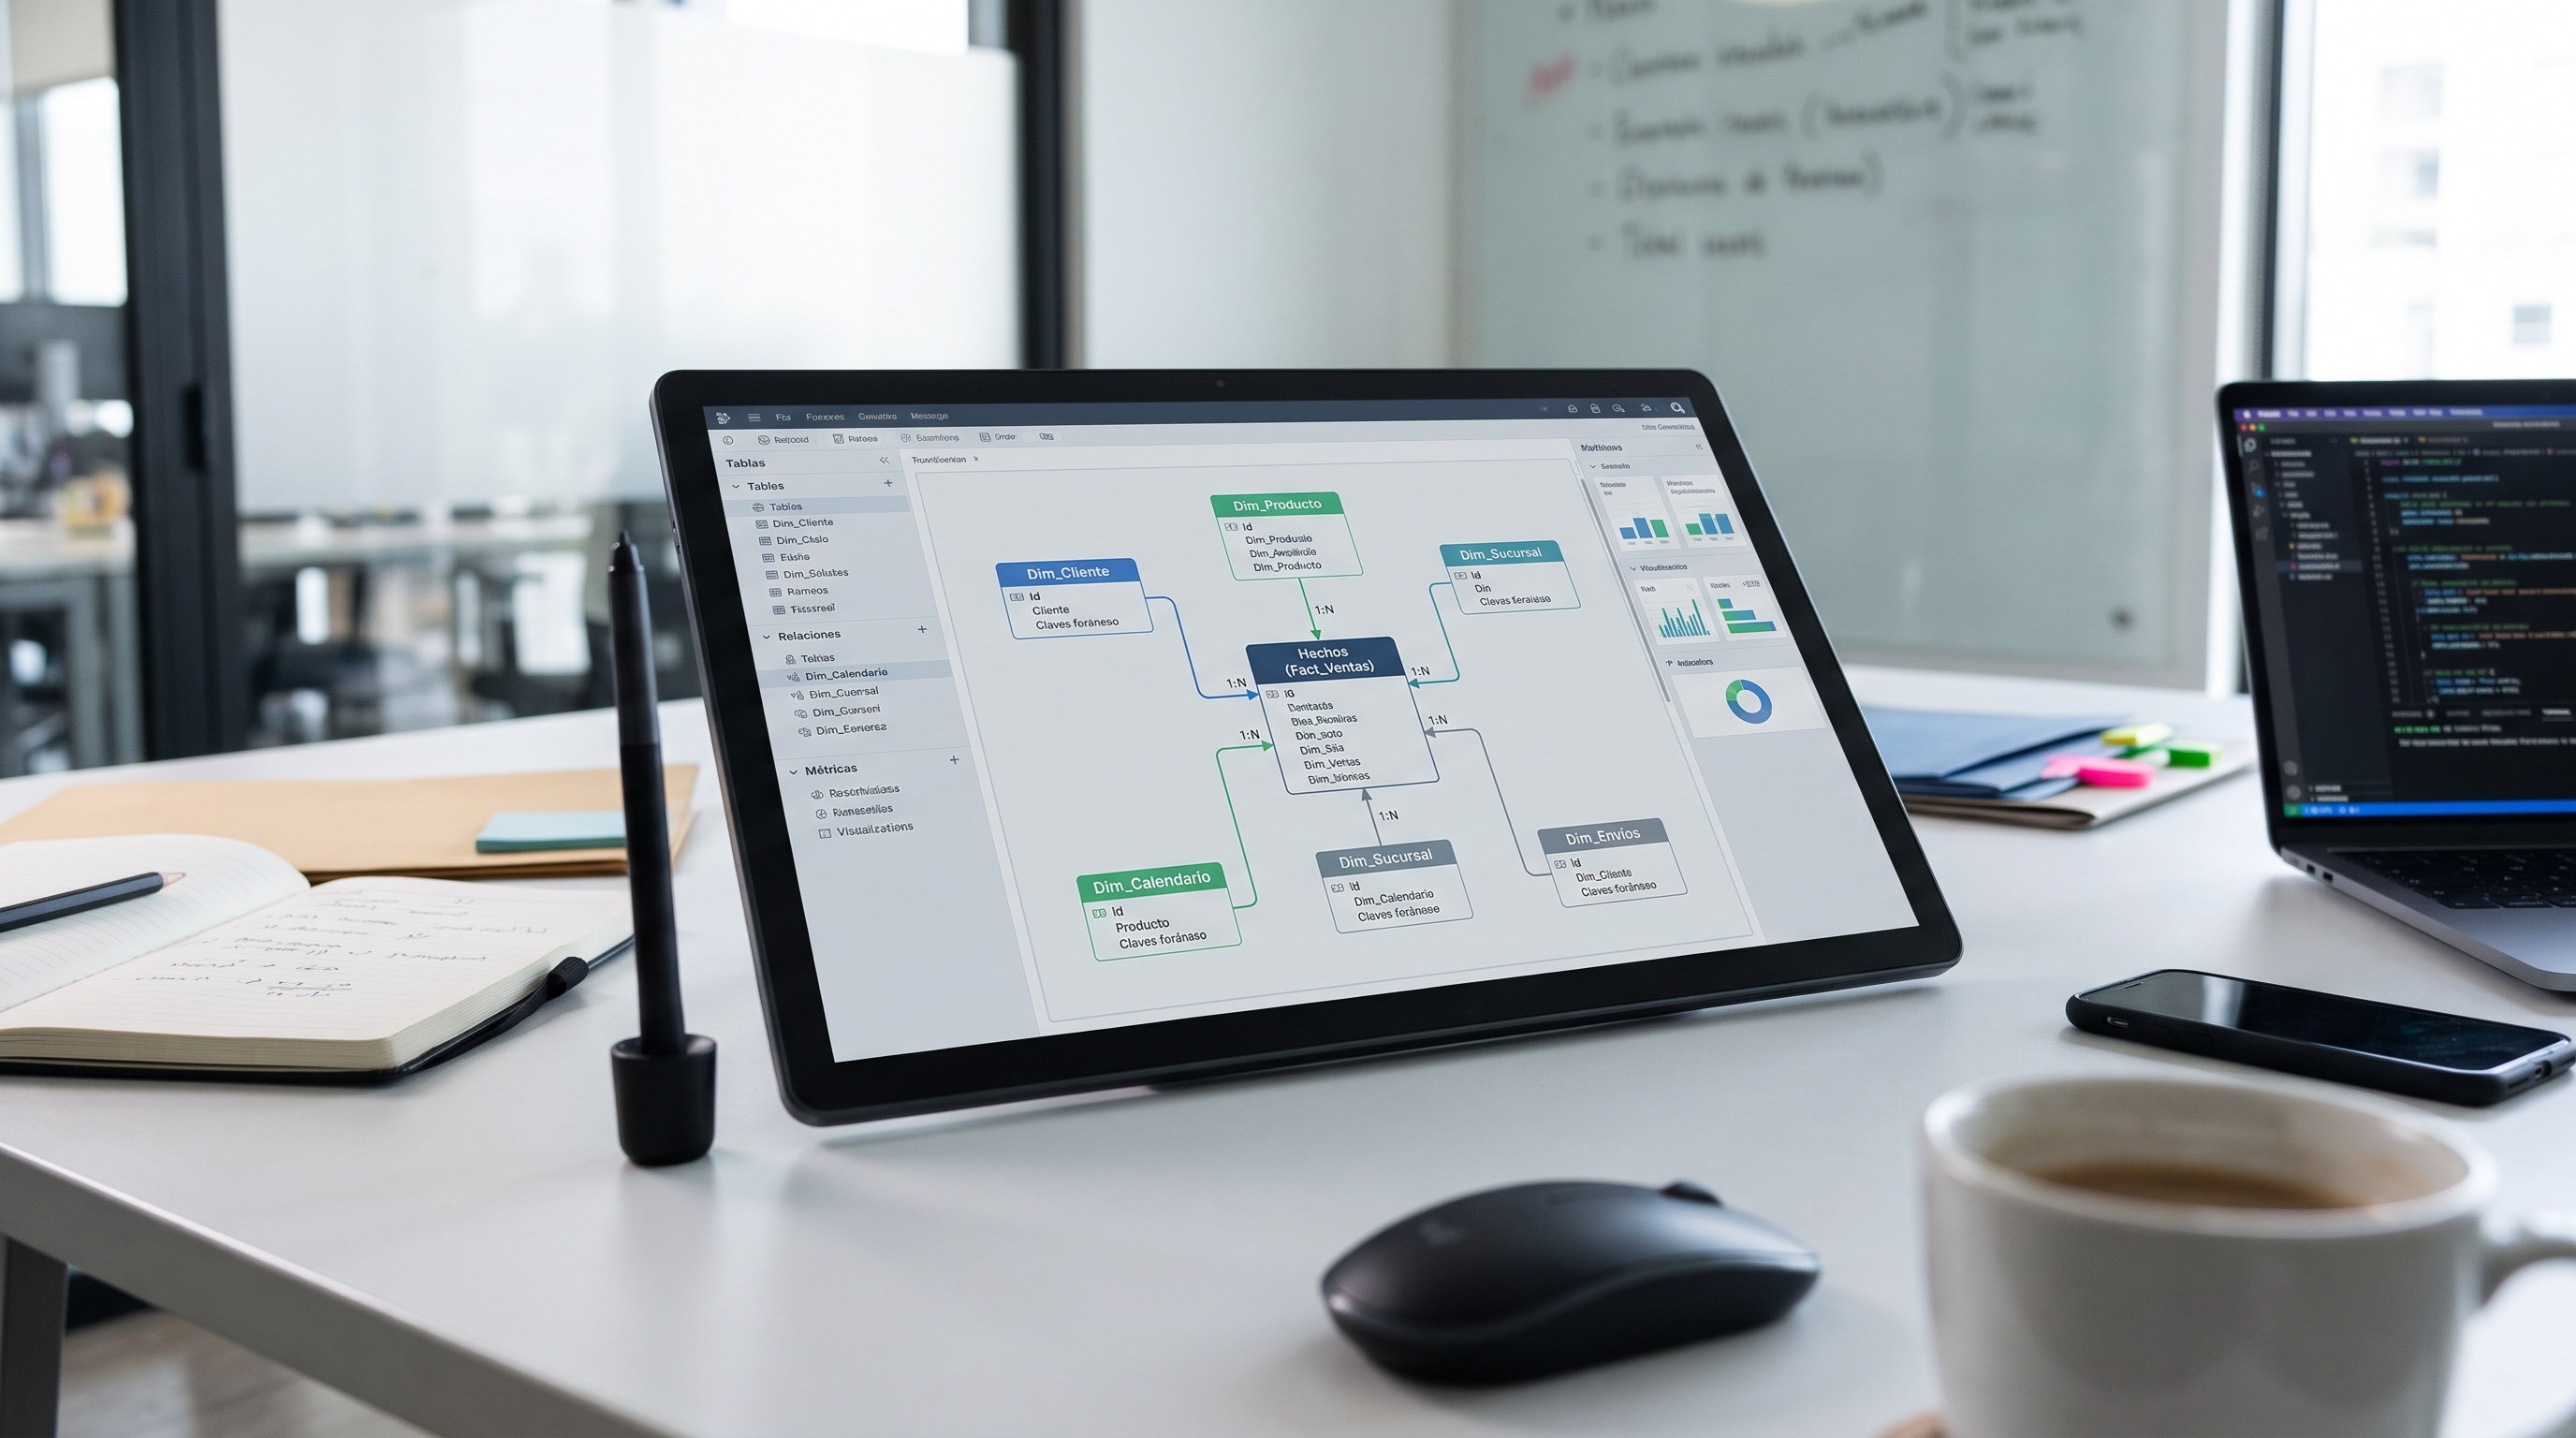
En un esquema en estrella, la tabla de hechos se ubica en el centro y se conecta directamente con múltiples tablas de dimensiones a través de sus claves primarias, formando una figura similar a una estrella.
| Componente | Tipo de Tabla | Clave de Conexión | Ejemplo de Atributos / Métricas |
|---|---|---|---|
| Centro | Hechos (Fact_Ventas) |
ID_Cliente, ID_Producto, Fecha_ID |
Cantidad, Total_Venta, Margen |
| Punta 1 | Dimensión (Dim_Cliente) |
ID_Cliente (Primary Key) |
Nombre, Email, Segmento |
| Punta 2 | Dimensión (Dim_Producto) |
ID_Producto (Primary Key) |
Categoría, Subcategoría, Costo_Base |
| Punta 3 | Dimensión (Dim_Calendario) |
Fecha_ID (Primary Key) |
Año, Mes, Trimestre, Día_Semana |
Regla de oro de las relaciones:
Las relaciones deben ser estrictamente de uno a muchos (1:N) con dirección de filtro único, donde el lado "uno" corresponde a la dimensión y el lado "muchos" a la tabla de hechos. Esto garantiza que un filtro aplicado sobre una categoría filtre limpiamente las transacciones sin generar cálculos ambiguos.
Si extraés estas tablas directamente desde un motor relacional corporativo, asegurate de estructurar las claves foráneas con consultas optimizadas siguiendo nuestro artículo sobre SQL para analistas y sus consultas clave.
4. Esquema en Estrella vs Esquema en Copo de Nieve (Snowflake)
- Estrella: Las dimensiones están completamente desnormalizadas en una sola tabla (ejemplo: la categoría del producto está dentro de la misma tabla de productos). Es el esquema recomendado para la gran mayoría de herramientas analíticas por su rapidez de cálculo.
- Copo de Nieve: Las dimensiones se encuentran normalizadas en subtablas (ejemplo: la tabla de productos apunta a una tabla de subcategorías, y esta a una de categorías). Ahorra almacenamiento en bases relacionales transaccionales, pero añade complejidad innecesaria a las consultas analíticas.
5. Implementación del modelo en herramientas de BI
Una vez estructuradas las tablas, el modelo se implementa en la herramienta de visualización elegida:
- Si trabajás en el entorno de Microsoft, podés trasladar esta arquitectura de relaciones siguiendo el tutorial sobre cómo crear un dashboard en Power BI paso a paso.
- Si tu solución está orientada a la web o Google Cloud, podés conectar las fuentes preparadas aplicando las pautas de cómo crear un reporte en Looker Studio paso a paso.
Saber justificar por qué elegiste un esquema dimensional en lugar de una tabla plana demuestra madurez técnica frente a los reclutadores. Podés incluir este tipo de arquitecturas en tu portfolio de analista de datos y repasar cómo explicar la diferencia entre hechos y dimensiones revisando nuestra guía de preguntas técnicas en entrevistas de análisis de datos.
- #modelado de datos dashboards
- #esquema en estrella tutorial
- #tablas de hechos y dimensiones
- #modelo dimensional bi
- #normalizacion de datos bi
- #optimizacion de reportes